MiniMax 推出推理模型 M3.1 Flash,在 Artificial Analysis 的 Intelligence Index 取得 42 分,较前代 M3 高 13 分,而每项任务成本不足前代一半。这个分数与 GLM-5.3-Flash 持平,略高于 Gemini 3.8 Flash 的 41 分,但仍落后 Deepseek V4.1 Flash 1017 的 45 分。
复杂推理进步最大
在测试复杂推理的「Humanity’s Last Exam」中,M3.1 Flash 取得 48% 得分,同时高于 Deepseek 与 GLM。针对研究级物理推理的 CritPt 基准,该模型在 71 条复杂题目中取得 22%,高于 GLM-5.3-Flash 的 15% 及 Gemini 3.8 Flash 的 18%,仅次于 Deepseek 的 24%。事实准确度方面,M3.1 Flash 在 AA-Omniscience 测试中答对 56% 题目,明显高于 GLM-5.3-Flash 的 28% 及 Deepseek 的 43%。该模型的幻觉率达 93%,属明显弱点,原因是它倾向回答所有测试题目,而非在不确定时表明无法作答。输出 Token 较少压低成本
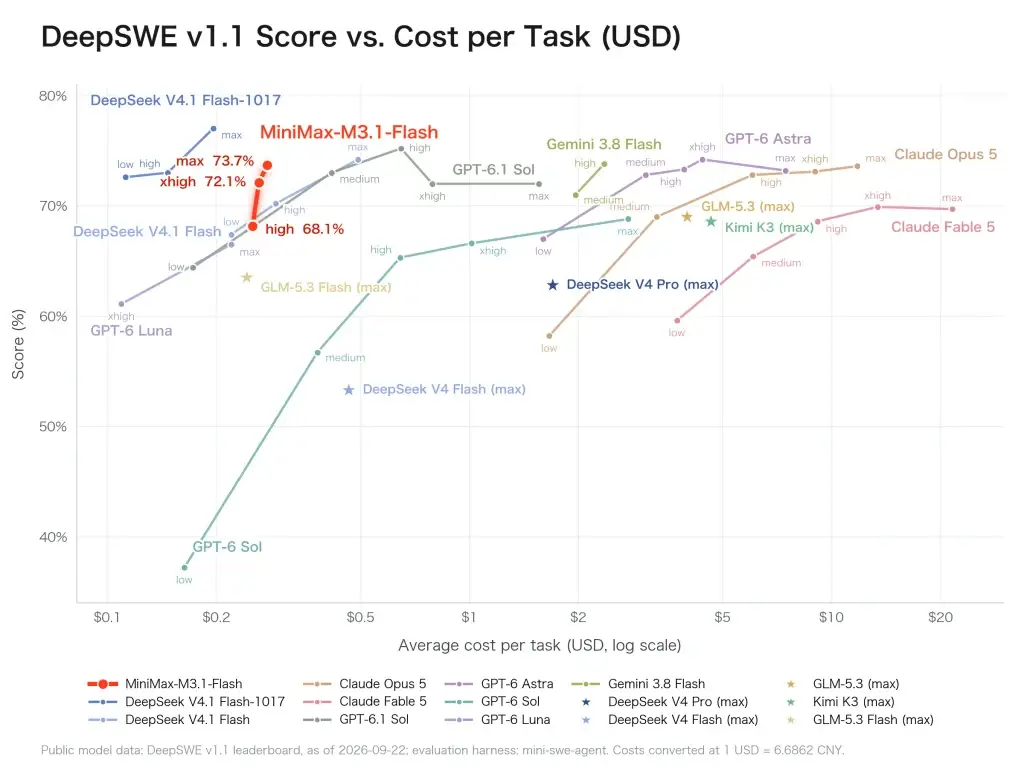
M3.1 Flash 的输出 Token 数量远少于竞争对手,令每项任务成本降至约 0.22 美元。MiniMax 表示,其运行速度为 M3 的三倍。在 DeepSWE v1.1 测试中,该模型得分最高达 73.7%,每项任务成本低于 0.30 美元。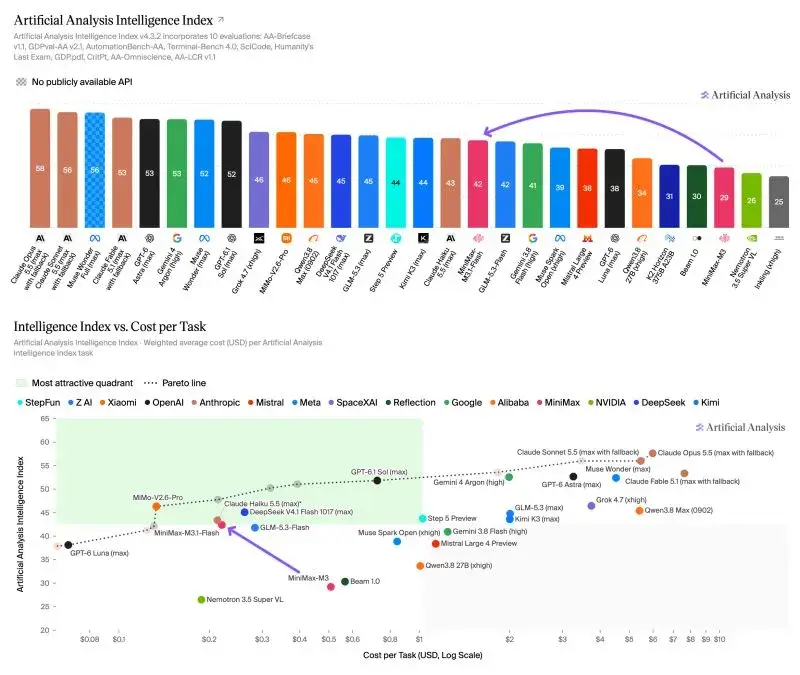
百万 Token 上下文与 API 收费
模型支持最多 100 万个 Token 上下文,可接收文字及图像输入。API 定价为每百万输入 Token 0.15 美元、每百万输出 Token 0.60 美元,缓存输入为 0.015 美元。MiniMax 计划于 10 月 23 日以开放权重形式释出模型;API 已在 platform.minimax.io 上线,公司同时提供名为 MiniMax Code 的桌面应用程序。
与 Deepseek 各有领先
与近期推出的 Deepseek V4.1 Flash 1017 直接比较,两款模型并非全面分出高下。Deepseek 在 Intelligence Index 以 45 分领先 MiniMax 的 42 分,在 CritPt 基准亦以 24% 稍胜 MiniMax 的 22%。
MiniMax 在其他测试中领先:「Humanity’s Last Exam」取得 48%,Deepseek 为 43%;AA-Omniscience 事实准确度为 56%,Deepseek 为 43%。由于整个基准测试所需的输出 Token 较少,MiniMax 每项任务成本为 0.22 美元,低于 Deepseek 的 0.26 美元;两者输出 Token 分别约为 1.89 亿个及 2.24 亿个。两款模型均将推出开放权重版本,Deepseek 已在 Hugging Face 上架,MiniMax 则于 10 月 23 日跟随。
原创文章,作者:云东方,如若转载,请注明出处:https://www.yundongfang.com/Yun1235.html